
Authentifizierung bei APIs
Im vorherigen Thema haben wir die Kommunikation mit TLS und mTLS abgesichert. Mit mTLS können sich auch die technischen Kommunikationspartner gegenseitig authentifizieren. Der Patientenservice kann damit beispielsweise überprüfen: „Ist das tatsächlich der zugelassene Laborservice?“
Bei einer reinen Service-to-Service-Kommunikation kann diese technische Identität bereits ausreichen. APIs werden jedoch nicht ausschließlich auf diese Weise genutzt. Häufig greifen Anwendungen im Kontext eines bestimmten Benutzers auf eine API zu, oder ein Client soll nur ganz bestimmte API-Funktionen verwenden dürfen. Dann reicht die Information „Das ist der Laborservice“ allein nicht aus. Die API muss zusätzlich feststellen können, in welchem Sicherheitskontext der Request erfolgt und welche Berechtigungen damit verbunden sind.
Genau hier kommen Authentifizierungs- und Autorisierungsmechanismen auf Anwendungsebene ins Spiel – beispielsweise API-Keys und Access Tokens.

„Bei einer Webanwendung melde ich mich mit Benutzername und Passwort an. Aber wie funktioniert das bei einer API?“
„Auch eine API muss wissen, wer auf sie zugreift. Nur läuft die Authentifizierung hier normalerweise nicht über ein Login-Formular bei jedem Aufruf. Stattdessen weist sich der Client beispielsweise mit einem API-Key oder einem Access Token aus.“

Viele Web-APIs sind zustandslos aufgebaut. Das bedeutet: Die API sollte einen Request grundsätzlich anhand der mit diesem Request übermittelten Informationen verarbeiten können. Deshalb sendet der Client die benötigten Authentifizierungsinformationen bei den jeweiligen API-Aufrufen mit.
Ein typisches Beispiel ist ein Access Token:
GET /api/v1/patienten/4711 HTTP/1.1
Host: api.novahealth-solutions.de
Authorization: Bearer eyJ...
Die API kann anhand des Tokens feststellen, in welchem Sicherheitskontext die Anfrage erfolgt.
💡 Wichtig: Authentifizierung beantwortet zunächst die Frage „Wer bist du?“. Die davon zu unterscheidende Autorisierung beantwortet „Was darfst du?“. Ein erfolgreich authentifizierter Client darf deshalb nicht automatisch jede Funktion einer API verwenden.
API-Keys – die einfache Variante
Eine einfache Möglichkeit zur Absicherung einer API ist ein API-Key. Dabei handelt es sich typischerweise um einen ausreichend zufälligen, nicht erratbaren Wert, der einem Client zugeordnet wird. Beispielsweise:
GET /api/v1/laborwerte HTTP/1.1
Host: api.novahealth-solutions.de
X-API-Key: sk_live_7f3a9b2c4d5e6f1a8b9c0d1e2f3a4b5c
Die API prüft den Key und kann darüber die Identität erkennen:

Damit eignen sich API-Keys unter anderem für einfache Machine-to-Machine- bzw. Service-to-Service-Szenarien. Beispielsweise könnte ein Labor-System automatisiert Daten an eine API der NovaHealth übertragen. Ein API-Key ist allerdings ein Secret. Wer ihn besitzt, kann ihn – sofern keine zusätzlichen Schutzmaßnahmen greifen – gegenüber der API verwenden. Er muss deshalb ähnlich sorgfältig geschützt werden wie ein Passwort.
⚠️ API-Keys gehören nicht in den Quellcode und erst recht nicht in öffentliche Git-Repositories. Wird ein Key versehentlich veröffentlicht, sollte er als kompromittiert betrachtet, widerrufen und ersetzt werden.
API-Keys haben außerdem Grenzen. Ein statischer Key identifiziert häufig einen Client bzw. eine Anwendung, aber nicht zwangsläufig den Benutzer, der eine Aktion ausgelöst hat. Außerdem müssen Keys sicher verteilt, gespeichert, widerrufen und regelmäßig erneuert werden können.
Ein professionelles API-Key-Management sollte daher mindestens Zuordnung, Berechtigungen, Widerruf bzw. Rotation und Protokollierung berücksichtigen.
Für komplexere Szenarien – insbesondere wenn Benutzeridentitäten und differenzierte Berechtigungen eine Rolle spielen – kommen häufig OAuth 2.0 und OpenID Connect ins Spiel.
OAuth 2.0 und OpenID Connect
OAuth 2.0 und OpenID Connect (OIDC) hast du bereits in Modul B4 kennengelernt. Zur Erinnerung: OAuth 2.0 dient primär der delegierten Autorisierung. Ein Client erhält ein Access Token, mit dem er auf geschützte Ressourcen zugreifen kann. OpenID Connect ergänzt OAuth 2.0 um eine standardisierte Authentifizierung des Benutzers.
Das Zusammenspiel sieht vereinfacht so aus:
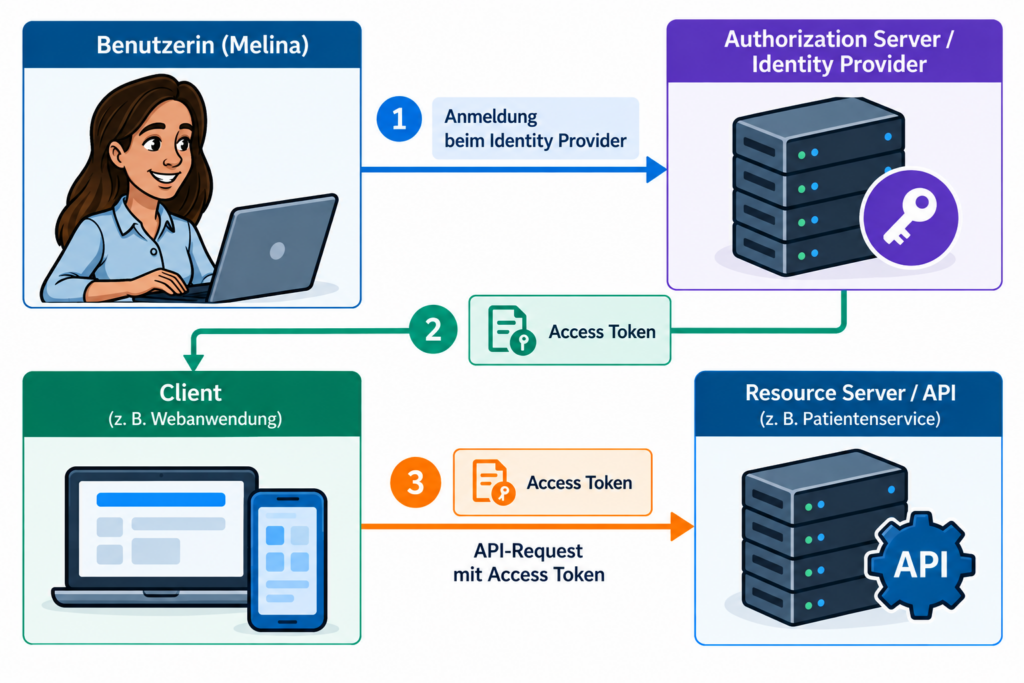
In der Praxis solltest du diese Funktionen nicht selbst neu erfinden. Etablierte Identity Provider bzw. Authorization Server wie Keycloak, Microsoft Entra ID oder AWS Cognito übernehmen beispielsweise Anmeldung, MFA, Token-Ausstellung und die Durchführung der entsprechenden OAuth-/OIDC-Flows.
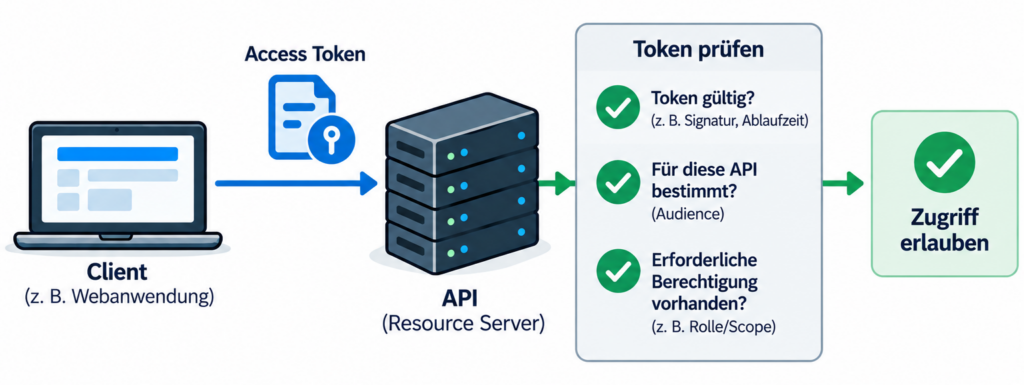
Die eigene API übernimmt dabei die Rolle des Resource Servers. Sie muss eingehende Access Tokens korrekt prüfen und anschließend entscheiden, ob der damit verbundene Zugriff erlaubt ist. Das ist ein wichtiger Unterschied:
Der Authorization Server kann beispielsweise bestätigen, dass der Zugriff im Kontext von Melina erfolgt. Die Patienten-API muss trotzdem prüfen, ob Melina genau diese Patientendaten lesen oder verändern darf.
Ein gültiges Token bedeutet also nicht automatisch: Zugriff erlaubt.
Der richtige Flow für den richtigen Client
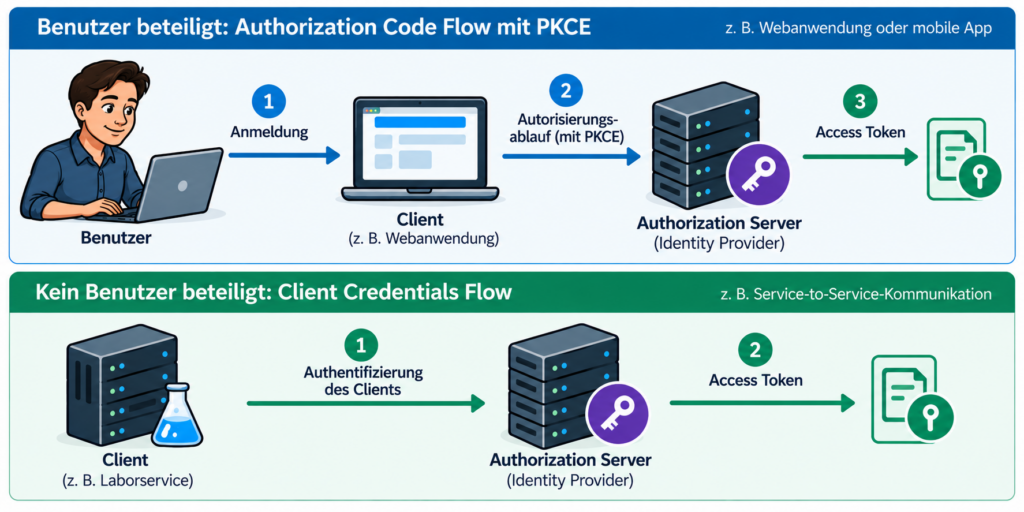
Bei OAuth 2.0 gibt es verschiedene Flows. Ein Flow beschreibt vereinfacht den Ablauf, wie ein Client eine Berechtigung erhält und an ein Access Token gelangt. Welcher Ablauf geeignet ist, hängt unter anderem davon ab, wer auf die API zugreift und ob dabei ein Benutzer beteiligt ist.
Zwei wichtige Beispiele:
- Authorization Code Flow mit PKCE: Wird typischerweise eingesetzt, wenn ein Benutzer über eine Anwendung auf eine API zugreift. Der Benutzer meldet sich beim Identity Provider an; die Anwendung erhält anschließend über einen abgesicherten Ablauf ein Access Token. PKCE steht übrigens für Proof Key for Code Exchange und wird in etwa „Pixy“ ausgesprochen. Es erweitert den normalen Authorization Code Flow um einen zusätzlichen Schutz gegen das Abfangen des Authorization Codes.
- Client Credentials Flow: Wird für Service-to-Service-Kommunikation ohne Benutzer verwendet. Hier authentifiziert sich der Client selbst beim Authorization Server und erhält ein Access Token für seine eigenen Berechtigungen.
Vereinfacht stellt sich das folgendermaßen dar:
Access Tokens
Nach erfolgreicher Autorisierung stellt der Authorization Server dem Client ein Access Token aus. Dieses Token sendet der Client anschließend bei API-Aufrufen mit:
Authorization: Bearer <Access-Token>Die API nimmt also nicht bei jedem Request erneut Benutzername und Passwort entgegen. Stattdessen prüft sie das Access Token. Ein Access Token sollte nur die notwendigen Berechtigungen besitzen und nur für die vorgesehenen APIs verwendet werden können.
JWT – ein häufiges Tokenformat
Ein Access Token berechtigt einen Client zum Zugriff auf eine API. Wie dieses Token technisch aufgebaut ist, ist damit noch nicht festgelegt. Häufig werden dafür JSON Web Tokens (JWT) verwendet. Ein JWT besteht aus drei Teilen:
HEADER.PAYLOAD.SIGNATURE- Header: enthält technische Angaben, beispielsweise zum Signaturalgorithmus.
- Payload: enthält sogenannte Claims, beispielsweise Benutzer, Rolle und Ablaufzeit.
- Signature: schützt das Token vor unbemerkter Manipulation.
Eine Payload könnte beispielsweise (vereinfacht) so aussehen:
{
  "sub": "nina",
  "role": "arzt",
  "exp": 1790503200
}
⚠️ Wichtig: Ein signiertes JWT ist nicht automatisch verschlüsselt. Header und Payload können gelesen werden. Sensible Daten gehören deshalb nicht ohne Weiteres hinein.
Access Token und Refresh Token
Access Tokens sollten nur begrenzt gültig sein. Wird ein Token gestohlen, begrenzt eine kurze Gültigkeitsdauer den möglichen Missbrauch. Damit sich ein Benutzer trotzdem nicht ständig neu anmelden muss, kann zusätzlich ein Refresh Token verwendet werden.
Das Refresh Token dient dazu, beim Authorization Server ein neues Access Token anzufordern. Ein Refresh Token wird vom Authorization Server erzeugt und zusammen mit bzw. zusätzlich zum Access Token an den Client ausgegeben. Ist das aktuelle Access Token ungültig, fordert der Client mit Hilfe des Refresh Tokens ein neues Access Token an:

Tokens sicher verwenden
Tokens sind Zugangsdaten und müssen entsprechend geschützt werden. Besonders wichtig sind drei Regeln:
- Tokens vollständig prüfen: Bei einem JWT beispielsweise Signatur, Aussteller (
iss), vorgesehene API (aud) und Ablaufzeit (exp). - Tokens sicher speichern: Sie dürfen nicht ungeschützt im Quellcode oder an leicht auslesbaren Stellen abgelegt werden. Bei Browseranwendungen sind insbesondere
localStorageundsessionStorageproblematisch, weil JavaScript darauf zugreifen kann. - Tokens nicht in URLs übertragen: URLs können beispielsweise in Logs und Browser-Historien auftauchen. Access Tokens werden stattdessen typischerweise im
Authorization-Header übertragen.
Besonders schützenswert sind Refresh Tokens, da mit ihnen neue Access Tokens angefordert werden können. Eine mögliche Schutzmaßnahme ist die Refresh-Token-Rotation: Bei jeder Verwendung wird ein neues Refresh Token ausgestellt und das vorherige ungültig.
Damit ergibt sich für einen API-Aufruf vereinfacht die folgende Prüfung:
Viel neuer Stoff? Prüfe dein Wissen zu API-Keys, Tokens und sicherer Token-Handhabung.